Gescannte PDFs übersetzen — ohne das Layout zu zerstören
Das Dokument wird übersetzt, die Seite bleibt.
Täglich 5 Seiten kostenlos · ohne Kreditkarte
Gleiches Layout, jede Sprache.
Scrollen Sie nach unten: drei echte Dokumente, in eine andere Sprache übersetzt.
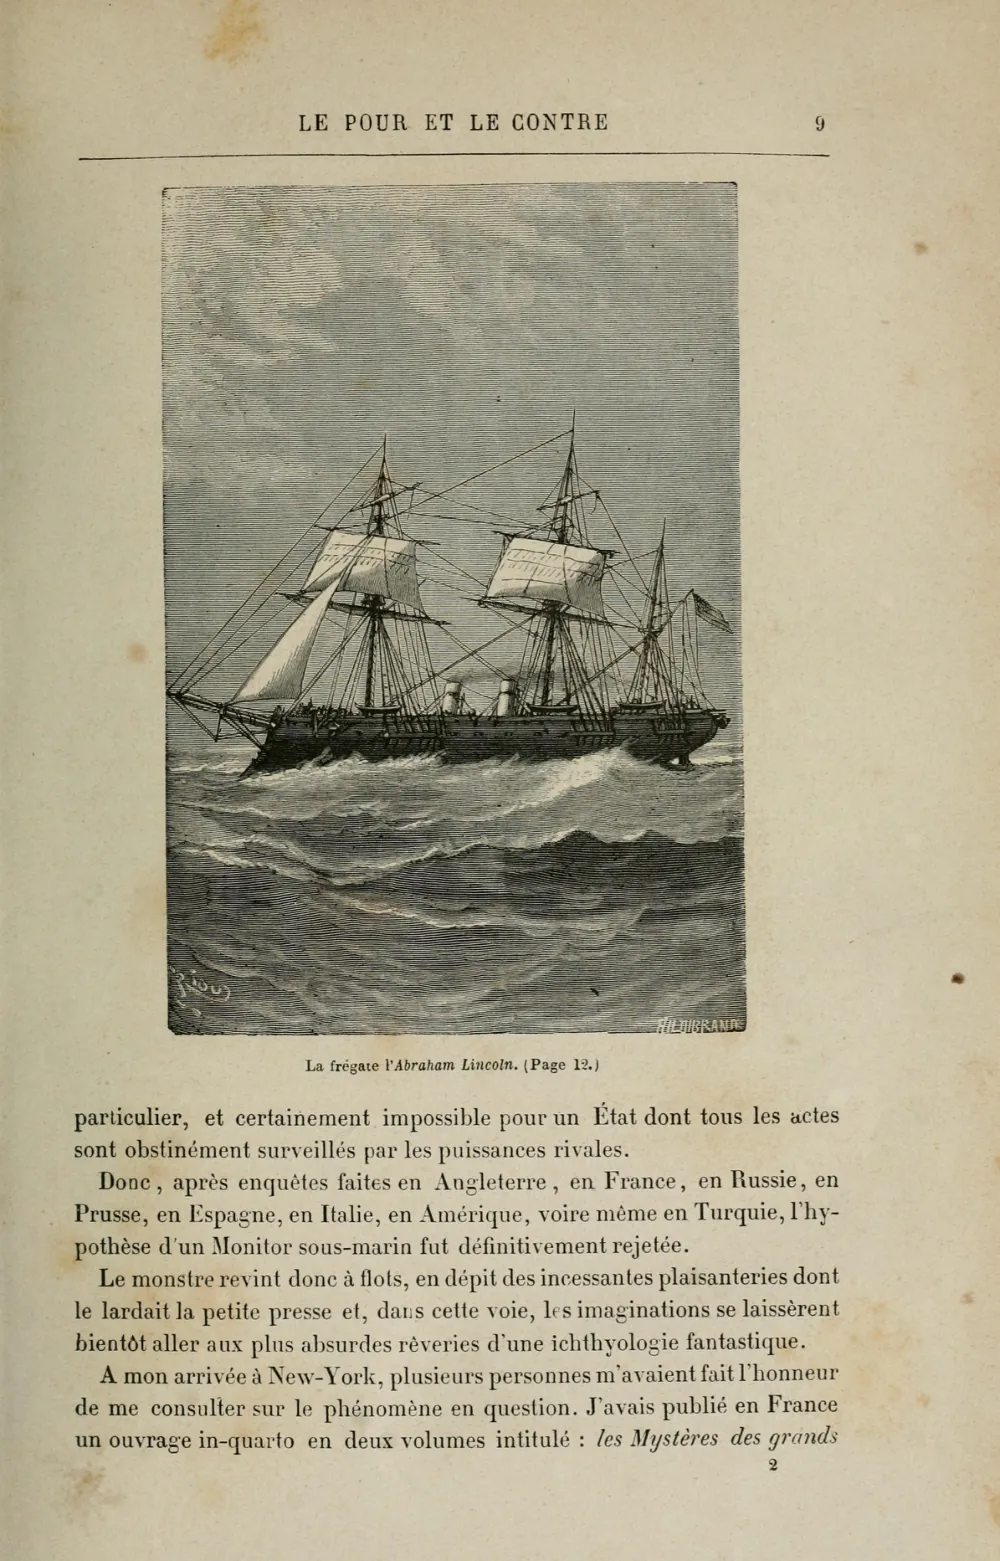
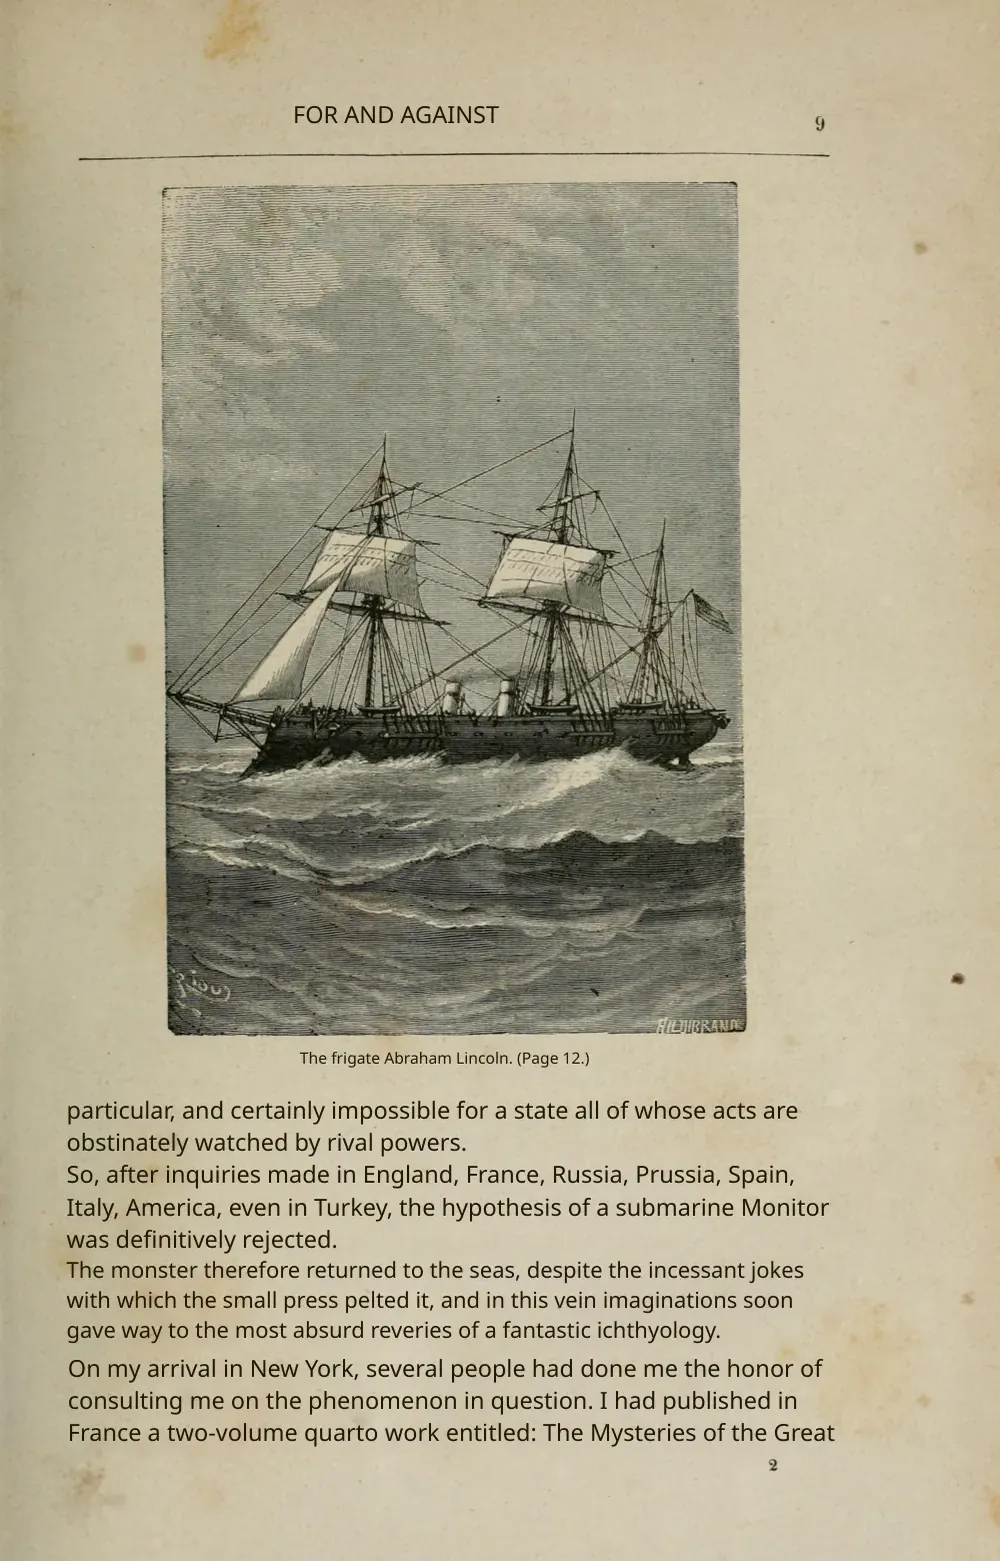
Japanisch → Englisch — Bedienungsanleitung · gescannt
Drei Schritte. Kein Abtippen.
Sie müssen keine OCR selbst ausführen und nichts von Hand nachformatieren.
PDF hochladen
Gescannte PDFs oder Bild-PDFs bis 100 MB. Ein Handy-Scan als PDF funktioniert auch.
Jede Seite wird an Ort und Stelle übersetzt
Der Originaltext wird entfernt, die Übersetzung kommt genau dorthin, wo er stand.
Dieselben Seiten herunterladen
Prüfen Sie jede Seite am Original und laden Sie sie herunter, auf Wunsch beide nebeneinander.
Was genau dort bleibt, wo es war
Tabellen & Spalten
Zeilen, Zellen und mehrspaltiger Text behalten ihre Form.
Stempel & Unterschriften
Siegel, Unterschriften und Zahlen bleiben unverändert.
Abbildungen & Fotos
Illustrationen und Fotos werden nicht nachgezeichnet.
Zweisprachiges PDF
Original und Übersetzung nebeneinander, Seite für Seite.
Gemacht für Seiten, die schwer zu übersetzen sind
Wählen Sie Ihren Dokumenttyp für Details oder laden Sie direkt hoch. Der Ablauf ist derselbe.
Geburtsurkunden
Registerfelder und Siegel bleiben an ihrem Platz.
Notenspiegel
Notentabellen behalten jede Zeile.
Kontoauszüge
Jede Zeile und jeder Saldo an seinem Platz.
Medizinische Unterlagen
Labortabellen und Befunde, Zeile für Zeile.
Juristische Dokumente
Klauselnummern & Überschriften bleiben erhalten.
Bücher & Manuskripte
Alte Drucke, Stiche und Fußnoten bleiben erhalten.
Wählen Sie Ihren Plan
Einfache Preise, gemacht für Scans. Seite ist Seite — kein Aufschlag für gescannte Dateien.
Nach Bedarf
Ein paar Seiten übersetzen. Ohne Verpflichtung.
$0.30 pro Seite, ab 10 Seiten — Sie zahlen genau 10 Seiten.
- Seiten verfallen nie
- Bis zu 100 MB pro Datei
Lite
Am beliebtestenFür alle, die jeden Monat Scans übersetzen.
- 0,09 $ / Seite
- 100 Seiten pro Monat
- Bis zu 100 MB pro Datei
- Kontingent wird monatlich zurückgesetzt
Pro
Für Vielnutzer, die jede Woche Scans übersetzen.
- 0,06 $ / Seite
- 500 Seiten pro Monat
- Ungenutzte Seiten werden übertragen (bis 1.500)
- Bis zu 100 MB pro Datei
Ratgeber zum Übersetzen gescannter Dokumente
Google Übersetzer: PDF übersetzen – Anleitung, Grenzen und was bei Scans hilft
PDF mit Google Übersetzer übersetzen: Anleitung, offizielle Grenzen (10 MB, 300 Seiten), die Meldung „Gescannte PDFs können nicht übersetzt werden“ und was auf dem Handy geht.
Ratgeber lesenKostenlose PDF-Übersetzer im Vergleich: Google, DeepL, ChatGPT & Co. (2026)
Google Übersetzer, DeepL, ChatGPT und Dokument-Tools im ehrlichen Vergleich: Welche Limits die kostenlosen PDF-Übersetzer haben, wie gut das Ergebnis ist und was bei gescannten PDFs übrig bleibt.
Ratgeber lesenGescannte PDF übersetzen: So klappt es mit Layout und Stempeln
Warum normale Übersetzer an gescannten PDFs scheitern — und wie Sie einen Scan mit OCR übersetzen, ohne dass Tabellen, Stempel und Formulare verrutschen. Täglich 5 Seiten gratis.
Ratgeber lesenGescannte PDFs übersetzen — häufige Fragen
Warum kommt beim Übersetzen meines gescannten PDFs nur Zeichensalat oder Kauderwelsch heraus?
Ein gescanntes PDF ist nur ein Bild von Text, ohne darunterliegende Textebene. Ein Übersetzer, der markierbaren Text erwartet, liefert deshalb entweder leere Seiten oder wirre, zufällige Zeichen. Die Lösung ist OCR (optische Zeichenerkennung), die das Bild zuerst ausliest. Reglyph führt vor dem Übersetzen eine OCR auf dem Scan durch — so erhalten Sie echten übersetzten Text statt Zeichensalat.
Warum erkennt Google Übersetzer in meinem gescannten PDF keinen Text?
Die meisten gängigen Übersetzer lesen nur PDFs, die bereits eine digitale Textebene enthalten. Ein reiner Bild-Scan hat keine — deshalb melden sie „Text nicht erkannt“, hängen sich auf oder überspringen stillschweigend Seiten. Reglyph ist genau für diesen Fall gebaut: Es erkennt den Text im Bild, sodass Sie die Datei nicht erst selbst umwandeln oder per OCR aufbereiten müssen.
Wie übersetze ich ein gescanntes PDF, ohne dass Layout, Tabellen und Spalten verloren gehen?
Übliche Tools kippen die übersetzten Wörter in eine einzige Textwüste — Tabellen fallen in sich zusammen, Spalten verschmelzen, Überschriften gehen im Fließtext unter. Reglyph entfernt den Originaltext von der Seite und setzt die Übersetzung an derselben Stelle neu, sodass Tabellen, Spalten, Abbildungen, Stempel und Zahlen genau dort bleiben, wo sie waren.
Muss ich das Dokument nach dem Übersetzen neu abtippen oder formatieren?
Bei den meisten Arbeitsweisen ja — viele berichten, dass sie pro Dokument 30–60 Minuten damit verbringen, die ursprüngliche Formatierung von Hand nachzubauen. Reglyph baut das Seitenlayout automatisch wieder auf, sodass das Ergebnis ohne manuelles Nachformatieren einsatzbereit ist.
Warum funktioniert ChatGPT oder der KI-Assistent meines PDF-Programms nicht bei gescannten Dokumenten?
Viele KI-Assistenten können nur die Textebene eines PDFs lesen und liefern bei reinen Bild-Scans stillschweigend nichts Brauchbares — eine Einschränkung, die oft erst erwähnt wird, nachdem Sie bezahlt haben. Bei Reglyph sind gescannte, reine Bild-PDFs der zentrale Anwendungsfall und kein nicht unterstützter Sonderfall.
Kann ich ein reines Bild-PDF oder ein Foto einer Seite übersetzen, ohne vorher selbst eine OCR durchzuführen?
Ja. Sie müssen weder einen separaten OCR-Schritt ausführen noch die Datei vorher in bearbeitbaren Text umwandeln. Laden Sie das gescannte PDF hoch (ein Handyfoto der Seite speichern Sie vorher als PDF, etwa mit der Scanner-App Ihres Handys) — Reglyph übernimmt Texterkennung, Übersetzung und Neusatz des Layouts in einem Durchgang.
Bleiben Stempel, Unterschriften und Zahlen an der richtigen Stelle?
Ja. Reglyph ersetzt nur den Text, den es übersetzt; Stempel, Siegel, Unterschriften, Abbildungen und Zahlenwerte behalten ihre ursprüngliche Position und werden nicht verändert — wichtig bei Urkunden, Verträgen und amtlichen Unterlagen.
Funktioniert das auch mit großen oder mehrseitigen gescannten PDFs?
Ja. Viele Übersetzer für gescannte PDFs streiken bei großen oder mehrseitigen Dateien. Reglyph verarbeitet Dokumente Seite für Seite, sodass auch mehrseitige Scans übersetzt werden und das Layout auf jeder Seite erhalten bleibt. Zum Ausprobieren haben Sie jeden Tag 5 Seiten kostenlos.
Welche Dateien werden unterstützt?
Gescannte PDFs (auch mit der Scan-App am Handy erstellte), Bild-PDFs ohne Textebene und normale digitale PDFs. Fotos bitte vorher als PDF speichern. Sauber gedruckte Vorlagen liefern das beste Ergebnis; viel Handschrift bleibt unzuverlässig.
Sind meine Dokumente sicher?
Hochgeladene Dateien werden nach 24 Stunden automatisch gelöscht und niemals zum Training von KI verwendet.
Ist das kostenlos?
Jeden Tag sind die ersten 5 Seiten kostenlos, ohne Kreditkarte. Bezahlpläne beginnen bei 3 $, mit über 12 verfügbaren Sprachen.